1. K8S 中 request 和 limit 区别
- request(请求):Pod调度的时候使用,代表 Pod 期望占用的最小资源。调度器根据节点剩余 request 总和判断节点是否能接纳 Pod。节点是按照 request 做资源预留。Pod 实际使用可以超过 request。
- limit(限制):Pod 资源最大上限。容器实际资源不能超过 limit。
- CPU:超过 limit,容器会被限流,不会杀死。
- 内存:持续超过 limit,容器会被 OOMKill 杀掉重启。
总结:
request=调度依据;limit=资源天花板如果不写 request,默认等于 limit;不写 limit,代表没有上限。
2. 你对 K8S 了解多少
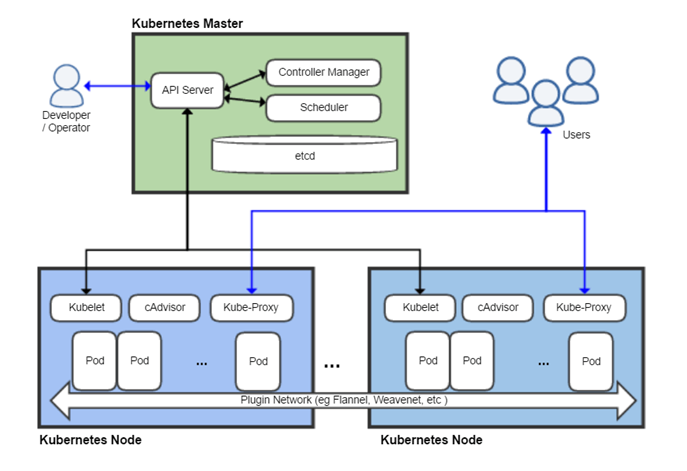
K8s 是容器编排平台,用于自动化容器部署、扩缩容、故障自愈。 整体分为控制平面 (control‑plane) + 工作节点 (node)
- 控制平面组件
etcd:集群数据库,保存集群所有状态数据kube‑apiserver:集群唯一入口,所有操作都走 API,鉴权校验kube‑controller‑manager:各类控制器,维持资源期望状态kube‑scheduler:调度器,把 Pod 分配到合适 Node
- 工作节点组件
kubelet:节点代理,管理本机 Pod 生命周期,和 apiserver 交互kube‑proxy:维护 Service 网络规则,实现 Pod 网络访问容器运行时:containerd/docker,真正跑容器
核心资源:Pod 最小调度单元;Deployment、StatefulSet、DaemonSet 控制器;Service、Ingress 负责流量;ConfigMap/Secret 配置管理;探针做健康检查。
3. K8S 控制器有哪些
- Deployment:无状态服务,滚动更新、回滚、扩缩容;底层使用 ReplicaSet 管理 Pod 副本。适合 web 服务。
- StatefulSet:有状态服务。稳定网络标识、稳定持久存储,有序部署 / 有序删除。适合 MySQL、Redis 集群、zookeeper。
- DaemonSet:每个(部分)节点运行一个 Pod。日志采集 agent、监控 agent、网络插件。
- ReplicaSet:维持指定数量 Pod 副本,一般不直接使用,由 Deployment 管理。
- Job:一次性任务,执行完成 Pod 退出。数据批处理。
- CronJob:定时 Job,定时任务,相当于 linux crontab。
4. K8S 监控怎么做
三层监控体系:节点监控、Pod 容器监控、业务应用监控
- metrics‑server:集群内置,收集 node/pod CPU 内存指标,提供给 HPA、kubectl top。只做短期指标,不持久化。
- Prometheus + Grafana(主流方案)
- prometheus‑operator 部署;
- node‑exporter:采集服务器硬件节点指标(CPU、磁盘、网络)
- kube‑state‑metrics:K8S 对象元数据,pod 状态、副本数、deployment 状态
- cadvisor:内置于 kubelet,采集容器 CPU 内存磁盘 IO
- ServiceMonitor/PodMonitor 自动发现 target
- Grafana 做可视化大盘;Alertmanager 实现告警(钉钉 / 邮件 / 企业微信)
- 应用层:业务埋点暴露 prometheus metrics 接口。
- 告警:Pod 异常、OOM、节点宕机、CPU 内存过高、PVC 存储满。
5. docker 网络模型有哪些
Docker 五种网络模式:
- bridge(默认网桥):docker0 网桥,容器之间同一网桥通信;容器 NAT 访问外网;容器外部不能直接访问容器 IP。
- host:直接复用宿主机网络命名空间。容器和宿主机共用网卡 IP,端口不能冲突;性能最好。
- none:关闭网络,容器没有网卡,完全隔离。
- container:复用另外一个容器的网络命名空间。Pod 内多个容器就是这种模式(共享 network namespace)。
- 自定义 bridge:用户自己创建网桥,用于隔离不同容器组。
注意:docker 原生 bridge不能直接用于 K8S,K8S 要求所有 Pod 直接互通,CNI 网络插件实现。
6. flannel 和 calico 区别
两者都是 K8S CNI 网络插件,实现 Pod 之间网络互通
Flannel
- 简单轻量,配置维护简单。只负责 Pod 网络通信,没有网络策略 NetworkPolicy。
- 后端模式:VXLAN(默认)、host‑gw。
- 适合:测试环境、规模不大集群,不需要网络访问控制。
- 缺点:不能做 pod 之间访问隔离;大规模性能一般。
Calico
- 基于 BGP 协议,支持NetworkPolicy 网络策略,可以做 Pod/IP 的访问控制(防火墙规则)。
- 三种模式:BGP、VXLAN、IPIP。
- 优点:功能强大,支持网络策略,大规模集群性能好,生产环境首选。
- 缺点:组件多,维护复杂度比 flannel 高。
面试话术:上家生产环境使用 Calico,需要网络策略做服务之间访问隔离;测试环境用 flannel 快速搭建。
7. k8s 日志收集怎么做
标准方案:ELK/EFK(Elasticsearch + Fluent‑Bit + Kibana)
- 容器日志标准输出:容器打印日志到 stdout/stderr,日志保存在节点
/var/log/containers目录。 - Fluent‑Bit(DaemonSet 部署,每个节点一个 pod)采集节点容器日志。
- 日志经过过滤处理发送到 Elasticsearch 存储。
- Kibana 做日志查询可视化。
可选方案:
- Filebeat 代替 fluent‑bit。
- 业务日志写 PVC 文件:sidecar 容器读取日志文件转发。
日志最佳实践:业务全部输出控制台 stdout,不要写容器内文件。
8. k8s 环境下代码上线
CI/CD 流水线(GitLab‑CI / Jenkins / ArgoCD)
- 开发者提交代码到 git 仓库触发流水线
- 编译代码,单元测试
- 构建 docker 镜像,推送镜像仓库 harbor
- 更新 k8s deployment 镜像版本
kubectl set image - Deployment 执行滚动更新 RollingUpdate:逐步创建新 pod,销毁旧 pod,保证服务不中断。
- 监控 pod 就绪探针,确认新版本启动成功。失败自动回滚上一个版本。
两种发布策略:
- 滚动更新(默认):新旧版本同时存在,平滑切换流量。
- 蓝绿发布:两套完整副本;新版本全部就绪,切换 service selector 标签,一次性切流量。资源消耗翻倍。
- 金丝雀发布:少量副本更新新版本,验证没问题后全量发布。
9. 对于有状态服务怎么处理
有状态:需要稳定网络标识、持久数据、有序启动停止(MySQL、Redis 集群、kafka)
- 使用StatefulSet 控制器
- Pod 拥有稳定 DNS 域名
podname.svcname.ns.svc.cluster.local - 有序部署、有序扩缩容、有序删除
- 自动绑定 PVC 持久存储,Pod 重建之后会挂载原来 PVC,数据不会丢失
- Pod 拥有稳定 DNS 域名
- Service 使用
headless service(clusterIP: None),用于 pod 域名解析。 - 数据备份:定时备份数据库 PVC 数据,避免存储故障。
- 集群初始化逻辑:利用 Pod 序号做集群节点编号。
⚠️不要用 Deployment 跑数据库,DeploymentPod 名称 IP 会变化,PVC 随机绑定,不适合有状态。
10. K8S 运维踩过哪些坑
- 资源没有配置 request/limit:节点资源争抢,Pod 随机 OOM,节点压力不可控。规范强制配置资源。
- 探针配置不合理:探针时间太短,服务还没启动完成就被 kill,Pod 反复重启。调大 initialDelaySeconds。
- 镜像拉取策略 imagePullPolicy:latest 标签镜像,版本混乱;生产禁止 latest,固定镜像版本。
- PV/PVC 存储问题:存储卷没有设置回收策略;节点异常 PVC 无法解绑导致 Pod 调度失败。
- Calico 网络坑:节点防火墙冲突,vxlan 网络不通;NetworkPolicy 写错导致服务之间无法访问。
- apiserver 证书过期集群直接不可用,要提前监控证书有效期。
- Deployment 更新策略 maxSurge/maxUnavailable配置过小,发布速度很慢。
- HPA 只配置 CPU,业务流量高但是 CPU 低不会自动扩容。需要自定义业务指标。
- Node 节点磁盘满:容器日志大量堆积,节点磁盘耗尽 kubelet 变成 NotReady。需要日志轮转。
- 大量 Pod 同时调度,导致 etcd 压力大,集群响应慢。
11. kubernetes 的 service 有哪些类型
- ClusterIP(默认):集群内部虚拟 IP。只能集群内部 Pod 访问,外部不能访问。用于服务之间调用。
- NodePort:在每一个节点打开一个端口。外部通过
节点IP:NodePort端口访问服务。端口范围 30000‑32767。适合测试。 - LoadBalancer:云厂商提供负载均衡器,外部真实 IP 直接把流量转发到 Service。公有云生产对外服务。
- ExternalName:把 service 映射外部域名,集群内访问 service 转发到外部域名。
补充:Service 只是四层负载均衡;七层 HTTP 流量交给 Ingress。
12. k8s 探针有几种,区别是什么
三种探针,都是 kubelet 执行。
- livenessProbe 存活探针:判断容器是否还活着。失败则杀掉容器重启。用于卡死无响应进程。
- readinessProbe 就绪探针:判断容器是否准备接收流量。失败会把 Pod 从 service 后端 endpoint 列表移除,不再转发流量。容器不会重启。用于服务启动初始化慢。
- startupProbe 启动探针:专门给启动很慢程序。启动探针成功之后才会执行存活和就绪探针。防止服务初始化还没完成就被 liveness 杀死。
探测方式:httpGet、tcpSocket、exec 命令。 重要参数:initialDelaySeconds初始延迟,periodSeconds探测间隔,failureThreshold失败阈值。
13. POD 生命周期
- Pending:API 创建 Pod,调度器寻找节点;拉取镜像过程。
- ContainerCreating:镜像下载完成,kubelet 创建启动容器。
- Running:所有容器启动成功。探针开始执行。
- Ready:readiness 探针成功,可以接收流量。
- Terminating:收到删除信号,进入终止流程。
- 发送 SIGTERM 优雅停止信号,等待 terminationGracePeriodSeconds 默认 30 秒。
- 超过时间直接 SIGKILL 强制杀死容器。
- Failed:容器异常退出,状态失败。
- Unknown:节点失联,apiserver 无法获取 pod 状态。
- Succeeded:一次性 Job 任务执行完成正常退出。
Pod 生命周期钩子:postStart(容器启动后执行),preStop(容器停止前执行)
14. pod 的调度算法
调度流程:预选 (Predicate) → 优选 (Priority)
- 预选策略 Predicate(过滤,不满足直接 pass 掉节点)
- PodFitsResources:检查节点剩余 request 资源,是否可以运行 Pod
- PodFitsHostPorts:检查 nodePort 端口冲突
- NodeSelector:节点标签匹配
- NodeName:指定节点名称
- Taints 和 Tolerations 污点容忍
- 优选策略 Priority(打分,0‑100,分数最高节点调度 Pod)
- LeastRequestedPriority:优先选择资源空闲多节点(默认)
- MostRequestedPriority:优先资源使用率高(高密度部署)
- BalancedResourceAllocation:CPU 内存资源尽量均衡分布
- NodeAffinity:节点亲和性打分
污点 Taint:节点排斥 Pod;容忍 Tolerations:Pod 可以容忍污点。 亲和性:Pod 想要调度带特定标签节点。
15. 如何升级 k8s 新版本
生产环境采用滚动升级,逐个节点升级,保证业务不中断。
- 备份 etcd 数据,备份集群配置 yaml。
- 使用 kubeadm 工具升级控制平面节点:
- 升级 kubeadm →升级 kubelet kubectl
kubeadm upgrade apply升级控制平面组件
- worker 节点操作:
- 设置节点不可调度
kubectl cordon node - 驱逐节点上所有 Pod
kubectl drain node - 升级本机 kubeadm、kubelet
kubeadm upgrade node- 恢复节点调度
kubectl uncordon node
- 设置节点不可调度
- 依次把所有 worker 节点完成升级。
- 验证集群状态
kubectl get nodes,检查 pod 全部正常运行。
⚠️etcd 版本、kube‑apiserver 版本兼容性;升级前检查证书有效期。
16. 你们 K8S 版本号多少?(面试口述参考)
参考话术:我们生产环境使用 1.27.x 版本,测试环境同版本。每半年评估新版本,不追最新版本,选择稳定 LTS 版本。不会随意升级,升级前会在测试环境完整验证。
17. 上家公司 K8S 用什么方式安装的
面试话术:集群是使用
kubeadm部署,多 master 高可用,三个控制平面节点。 不建议说二进制,现在企业主流 kubeadm。
18. ingress 控制器有哪些
Ingress 只是 k8s 资源对象,Ingress‑Controller 才真正实现七层反向代理
- ingress‑nginx(kubernetes 官方)企业最常用生产,Nginx 实现。
- APISIX云原生网关,基于 OpenResty,性能高,很多新特性。
- Traefik:自动发现,配置简单,适合云原生环境。
- Istio Gateway:服务网格 istio 组件。
区分 Ingress 资源和 IngressController:只写 Ingress yaml 不会生效,必须部署控制器 pod。
19. 上家公司总共多少个 POD,节点多少个。平时流量多少?
面试口述参考(真实企业规模): 集群一共25 个节点;3 个 master 控制节点,22 台 worker 工作节点。 日常运行 Pod 总数大概 450‑550 个 Pod。 业务 QPS 日常 2000‑4000,高峰期可以到 12000QPS。存储使用 CSI 对接分布式存储。
可以根据自己情况微调数字,不要写过于夸张。
20. K8S 哪些组件用到证书
K8S 所有组件通信全部 TLS 证书加密。
- kube‑apiserver:核心证书。对外 https 证书;和 etcd 通信证书。
- etcd:etcd 集群内部通信证书;apiserver 访问 etcd 客户端证书。
- kubelet:kubelet 客户端证书,向 apiserver 通信;apiserver 访问 kubelet 证书。
- kube‑scheduler:客户端证书,访问 apiserver。
- kube‑controller‑manager:客户端证书访问 apiserver。
- kube‑proxy:客户端证书访问 apiserver。
- ServiceAccount:内置 token 证书,pod 内部访问 apiserver。
kubeadm 管理证书,证书默认有效期 1 年;必须监控证书到期时间,证书过期整个集群直接瘫痪。